Один баг в ядре Linux десять лет раздавал root без единой гонки
•Репа
#атаки#код
Баги в ядре Linux, которыми занимаются всерьёз, почти всегда про гонку. Нужно поймать окно в несколько тактов между проверкой и использованием, разложить кучу так, чтобы освободившийся объект переехал под твой контроль, и повторить попытку столько раз, сколько потребуется, пока планировщик не встанет удачно. CVE-2026-74580 в подсистеме vhost не про это. Здесь нет окна, нет повтора и нет grooming: короткая последовательность ioctl кладёт в кеш ядра запись, которая переживает своё законное значение, и дальше каждый следующий вызов детерминированно пишет или читает по любому адресу ядра. Один и тот же баг с одного и того же праймленного устройства даёт на хосте произвольную запись и чтение памяти ядра, а из гостевой виртуалки – перехват RIP процесса QEMU на хосте. kernel.org оценил его в 8.8 High, затронуты ядра от 4.11 до 7.2, то есть почти десять лет релизов.
Самое неприятное в нём – не векторы, а то, что он собран из двух коммитов, каждый из которых по отдельности безупречен. Ни в одном нет ошибки. Ошибка живёт в том, как они легли друг на друга и десять лет никто не смотрел на их композицию.
Кеш, который ручается за проверку, которой не было
vhost держит метаданные каждой виртуальной очереди – кольца дескрипторов desc, доступных буферов avail и использованных used – за трансляцией через device IOTLB. Чтобы не гонять эту трансляцию на каждый доступ, в ядре с 4.11 живёт одноуровневый кеш vq->meta_iotlb[]: он хранит vhost_iotlb_map, подложивший память под каждую из трёх областей. Проверка доступа iotlb_access_ok() на попадании в кеш уходит коротким путём:
if (vhost_vq_meta_fetch(vq, addr, len, type))
	return true;
А сам vhost_vq_meta_fetch() не делает никакой проверки диапазона – он просто арифметикой переводит IOVA в пользовательский указатель:
return (void __user *)(uintptr_t)(map->addr + addr - map->start);
addr и map->start – оба 64-битные, их разность ничем не ограничена, и результат осмыслен ровно до тех пор, пока addr действительно лежит внутри map. Кеш сбрасывается на VHOST_IOTLB_UPDATE, на VHOST_IOTLB_INVALIDATE, при инициализации device-IOTLB и при сбросе очереди. Но не на VHOST_SET_VRING_ADDR и не на VHOST_SET_VRING_NUM. А именно этими двумя ioctl оператор меняет адреса колец на живой очереди.
Дальше включается вторая половина. Когда к очереди привязан device IOTLB, адреса в кольцах – это GIOVA, гостевые IO-виртуальные адреса, и vq_access_ok() на этапе ioctl намеренно возвращает true сразу: валидация отложена на момент prefetch, потому что проверять GIOVA в ioctl-контексте нечем. План был такой – адрес проверит vq_meta_prefetch() перед первым доступом. Но как только кеш заполнен, этот момент не наступает никогда: vq_meta_prefetch() попадает в протухшую запись и возвращает true, а vhost_vq_meta_fetch() продолжает транслировать уже новый адрес через старую карту. Отложенная проверка не исполняется, потому что её караулит кеш, который сам же докладывает, что всё уже проверено.
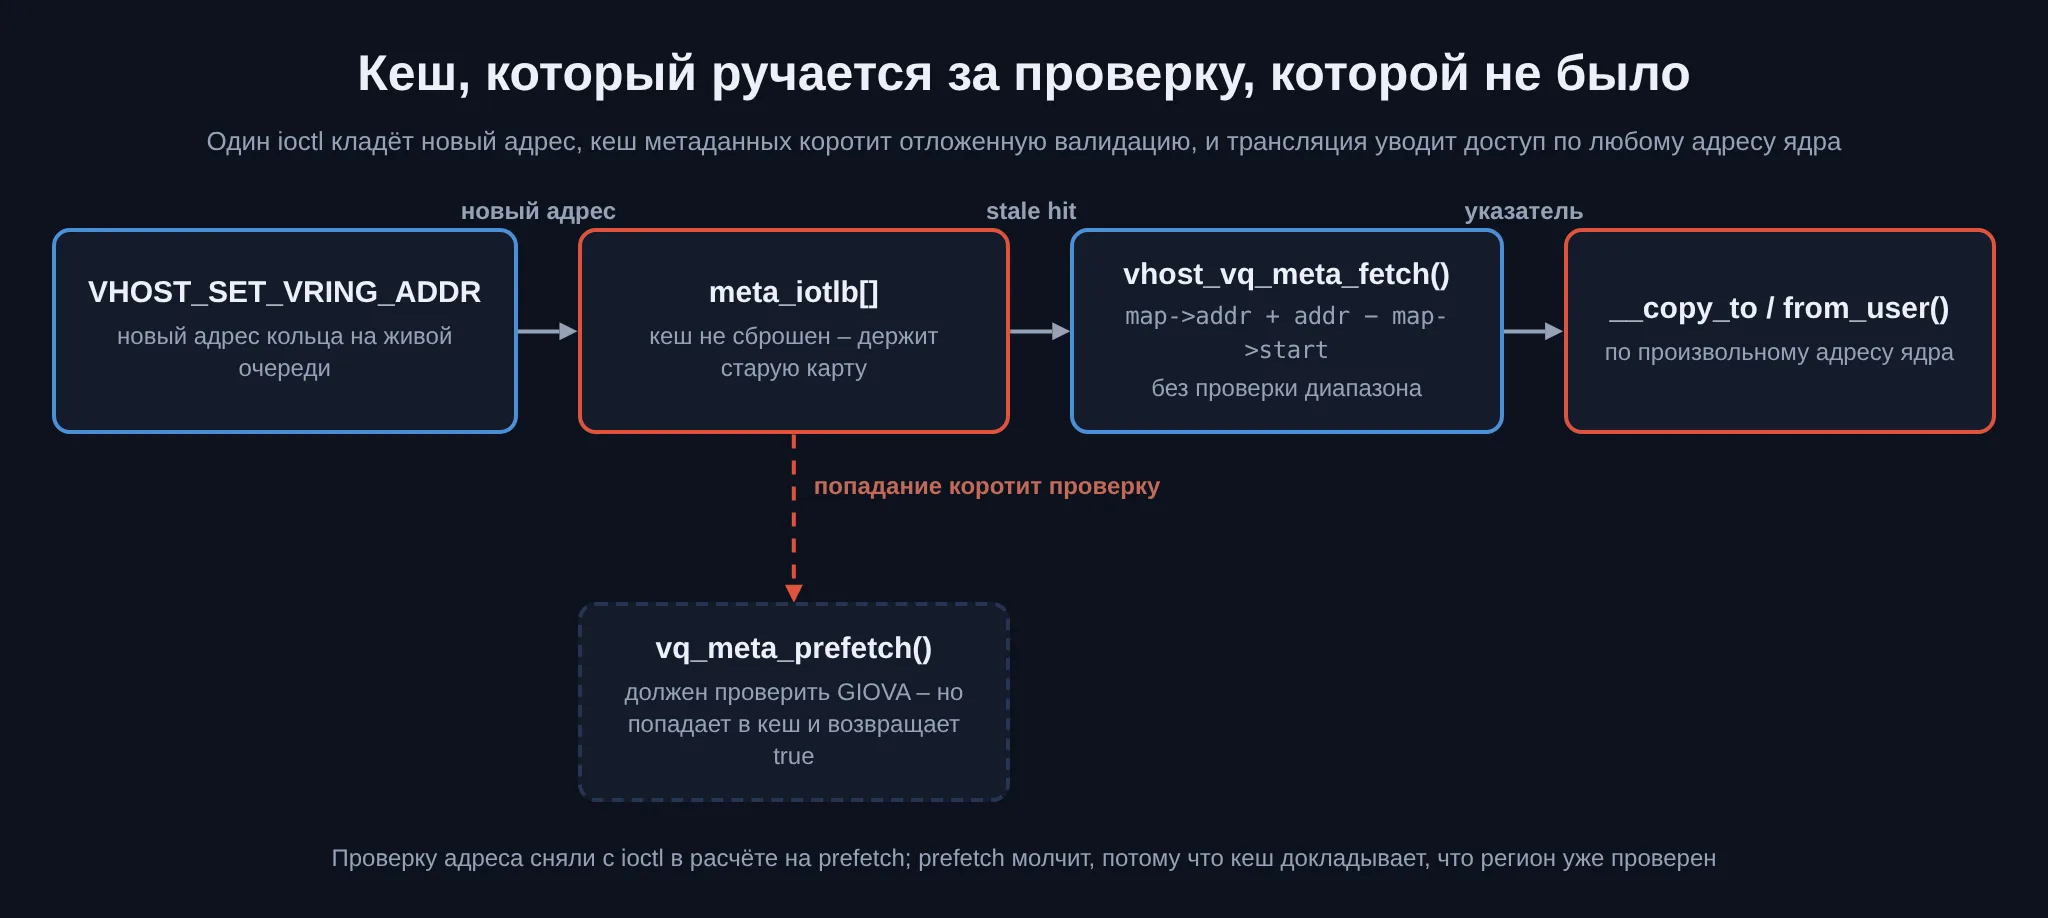
Склейка видна по датам. Коммит f88949138058 (v4.11, февраль 2017) добавил кеш meta_iotlb[] и ранний возврат в iotlb_access_ok(). Коммит 0210a8db2aec (v5.9, октябрь 2020) вынес валидацию GIOVA из ioctl в prefetch. Решение 2020 года само по себе разумное: держать проверку GIOVA в ioctl нечем, в prefetch она ляжет естественно, да ещё и экономит лишний проход на горячем пути настройки очереди. Но на нашу оценку оно встаёт иначе – на том же месте сброс кеша прямо в VHOST_SET_VRING_ADDR стоил бы ровно один вызов __vhost_vq_meta_reset() и снял бы весь класс целиком, а «проверю позже» без инвалидации кеша превратилось в «не проверю никогда». Цена отложенной валидации, когда её сторож – несбрасываемый кеш, оказалась в десятилетие живого stale mapping. Автор коммита 2020 года не мог этого видеть: кеш существовал тремя годами раньше и к GIOVA-пути отношения вроде бы не имел.
Транслированный указатель не остаётся абстракцией. На записи он доходит до vhost_put_used() → vhost_copy_to_user() → __copy_to_user(), на чтении – до vhost_get_desc() → __copy_from_user(). На x86-64 оба упираются в raw_copy_to_user() / raw_copy_from_user(), то есть в stac(); rep movsb; clac() без всякого access_ok() и без маскирования пользовательского указателя. Доступ происходит ровно по тому адресу, который выдала протухшая трансляция. Никакой страховки между арифметикой и физическим доступом к памяти нет – её сняли на этапе ioctl в расчёте на prefetch, а prefetch молчит.
Один дескриптор превращается в произвольную запись ядра
Кеш накрывает desc, avail и used одинаково, поэтому с одного праймленного устройства получаются два независимых примитива. Начнём с записи. Один завершённый дескриптор заставляет vhost положить в кольцо used восьмибайтовый vring_used_elem вида { .id = <head>, .len = 0 } – это два выбранных атакующим байта (значение head ограничено vq->num, а оно не больше 0x8000), за которыми идут шесть нулей. Сам по себе такой примитив кладёт восемь предсказуемых байт по одному адресу. Фокус в том, что между кусками (kick) кольцо used можно переставлять новым VHOST_SET_VRING_ADDR, и каждая запись садится по произвольному адресу.
Остаётся выравнивание. Поле used_user_addr обязано быть кратно четырём, но эффективное выравнивание записи – это (map->addr - map->start) mod 4, и оба слагаемых выбирает атакующий. Взяв uaddr нужной IOTLB-карты, доходишь до любого байтового сдвига. Записывая строку байт за байтом спереди назад, получаешь полный контроль произвольной записи – не «восемь байт по выровненному адресу», а что угодно и куда угодно в адресном пространстве ядра.
Тот же кеш, развёрнутый на чтение
Чтобы читать, переставляют не used, а desc_user_addr. Теперь vhost достаёт desc[0] с произвольного адреса ядра, и первые восемь байт цели – desc[0].addr – трактуются как IOVA буфера данных. Этот IOVA промахивается мимо IOTLB, и vhost честно рапортует о промахе сообщением VHOST_IOTLB_MISS, в поле iova которого лежат те самые восемь байт, уехавшие прямиком обратно в пользовательское пространство:
repoint desc_user_addr = <target>     (stale cache -> нет ревалидации)
→ kick -> vhost читает desc[0] из <target>
→ desc[0].addr = *(u64 *)<target>
→ это значение идёт как IOVA, промахивается мимо IOTLB
→ сообщение VHOST_IOTLB_MISS возвращает 8 байт
Восьмибайтовое произвольное чтение ядра, построенное на штатном механизме сообщений о промахе трансляции. Диагностический путь, который должен был сказать «такого адреса в таблице нет», превращён в канал эксфильтрации памяти ядра по восемь байт за запрос.
KASLR сдаёт себя через нулевой вектор прерываний
Примитив чтения нужно на что-то навести, а для этого – знать сдвиг KASLR. Его отдаёт нулевой вентиль таблицы дескрипторов прерываний. IDT лежит по фиксированному адресу 0xfffffe0000000000 в CPU entry area – рандомизация туда не достаёт. Вентиль 0 – это вход asm_exc_divide_error. Его первые восемь байт несут младшее и среднее поля смещения обработчика плюс селектор кодового сегмента; обработчик собирается обратно из этих полей и канонических старших бит, а сдвиг – это разница с линк-тайм символом:
handler     = reconstruct(IDT[0])
KASLR_slide = handler - link_time_asm_exc_divide_error
Чтобы не принять мусор за адрес, селектор сверяется с кодовым сегментом ядра (0x0010), а восстановленный обработчик – с ожидаемым выравниванием. Дальше сдвиг прикладывается к долгоживущим символам – например, к modprobe_path. Классика: перезаписать modprobe_path на путь к своему помощнику, дёрнуть исполнение файла с неизвестной сигнатурой – и ядро само запустит твой бинарь от root. На живом прогоне это выглядит буднично:
ubuntu@resolute-vsock:~$ id
uid=1000(ubuntu) gid=1000(ubuntu) groups=1000(ubuntu),...,991(kvm)
ubuntu@resolute-vsock:~$ ./vhost-poc-resolute --exploit
=== Ubuntu 26.04 vhost stale-IOTLB PoC (exploit) ===
[*] Step 1: KASLR bypass via IDT[0] read
[+] IDT[0] raw: 0xbb208e0000100940
[+] off_lo=0x0940 sel=0x0010 off_mid=0xbb20
[+] asm_exc_divide_error runtime: 0xffffffffbb200940
[+] KASLR slide: 0x3a200000
[+] Runtime modprobe_path @ 0xffffffffbde1fc20
[*] Step 3: Overwriting modprobe_path
[*] Step 4: Triggering
[+] SUCCESS! Got root code execution.
ubuntu@resolute-vsock:~$ /var/tmp/.vhost-poc-rootsh -p
# id
uid=0(root) gid=0(root) groups=0(root)
Уязвимы фронтенды vhost-net и vhost-vsock. Привилегий сверх открытия узла устройства не нужно никаких – дальше всё делает одна последовательность ioctl.
Пять дистрибутивов, один бинарь, и разница только в правах на узел
Один и тот же дженерик-эксплойт под x86-64 отработал на всех пяти целях. Он разрешал asm_exc_divide_error и modprobe_path из заранее подложенного System.map, снимал живой сдвиг KASLR из нулевого вентиля IDT, брал чтение и запись ядра, а перед сдачей настоящего шелла с UID 0 возвращал исходное значение /proc/sys/kernel/modprobe на место. После каждого прогона modprobe снова указывал на /sbin/modprobe, временный root-помощник был убран – чистый выход без следов на диске.
| Дистрибутив | Ядро | /dev/vhost-vsock |
Итог |
|---|---|---|---|
| Ubuntu 26.04 LTS | 7.0.0-28-generic | 0660 root:kvm |
юзер группы kvm uid=1000 → root |
| RHEL 9.8 | 5.14.0-687.5.3.el9_8 | 0666 root:kvm |
непривилегированный юзер → root |
| Amazon Linux 2023 | 6.1.180-225.360.amzn2023 | 0666 root:kvm |
непривилегированный юзер → root |
| Azure Linux 3.0 | 6.6.150.1-1.azl3 | 0666 root:kvm |
непривилегированный юзер → root |
| Oracle Linux 10.2 | 6.12.0-204.92.4.2.el10uek | 0666 root:kvm |
непривилегированный юзер → root |
Разница между дистрибутивами – не в качестве примитива, а в том, кто дотянется до узла. Четыре образа из пяти выставляют /dev/vhost-vsock в режиме 0666 с доступом на запись всему миру – это дефолтные udev-правила systemd. Ubuntu единственная сузила узел до 0660 root:kvm. Решение systemd раздавать vhost-устройства мирозаписываемыми понятно по-своему: инструментарий управления виртуализацией крутится под разными сервисными учётками, и 0666 снимает вопрос прав разом. Но на нашей шкале exposure-по-умолчанию против удобства это удобство оплачено дорого – на четырёх дистрибутивах до полного LPE дотягивается вообще любой локальный пользователь, без всякой групповой принадлежности. Выбор Ubuntu дешевле ровно на один класс атакующих: 0660 root:kvm всё ещё открыт члену группы kvm, но закрыт случайному юзеру с веб-шелла. На машине, где вертятся чужие контейнеры или где у веб-приложения своя учётка, этот один класс – вся разница между «нужен доступ в kvm» и «нужен любой shell».
Ни гонки, ни grooming, ни пересборки под ядро
Примитивы следуют из инварианта кеша, а не из гонки и не из конкретной раскладки кучи. После того как IOTLB-кеш заполнен, каждый VHOST_SET_VRING_ADDR с последующим kick даёт ровно одно чтение или одну запись ядра по транслированному адресу. Хватает одного процесса и короткой последовательности ioctl – ни стадии grooming, ни цикла повторов. В этом и состоит контраст с гоночными LPE: в отличие от гонки в Bad Epoll, где успех приходилось выжимать повтором до долей процента вероятности через false sharing и таймерное прерывание, здесь нет ни окна, ни ставки на планировщик. Кеш просто не сбрасывается – и результат воспроизводится каждый раз.
Отдельно стоит отметить, как построен примитив, – это сильный ход исследователя, а не данность бага. Эксплойт не ходит по объектам ядра через offsetof(), поэтому его не нужно перенастраивать, когда меняется раскладка структур. Ему достаточно долгоживущих символов – asm_exc_divide_error и modprobe_path, – а сам уязвимый путь не менялся с v5.9 по 7.2-rc4. Переезд на другую сборку сводится к разрешению этих двух символов в другом System.map. Альтернатива – примитив, завязанный на offsetof() по полям конкретной структуры, – дала бы хрупкую штуку, которую надо перетюнивать под каждое ядро и каждый вендорский бэкпорт. Цена портируемости здесь – необходимость заранее иметь System.map цели; за это один дженерик-бинарь кладёт пять разных дистрибутивов без единой правки. Для LPE, который должен работать «в поле» по незнакомым заранее ядрам, размен выбран правильно.
Тот же баг, но теперь его дёргает гость
Всё описанное выше предполагает атакующего, который уже сидит на хосте и открывает /dev/vhost-* руками. Но vhost для того и сделан, чтобы ускорять ввод-вывод виртуалок, обмениваясь дескрипторами напрямую через общие виртуальные очереди. Раз он обслуживает гостя напрямую, тот же stale-cache дёргается и изнутри гостя – штатными операциями virtio, без всякого доступа к хосту.
Когда virtio-устройство стоит за виртуальным IOMMU и включён iommu_platform (согласован VIRTIO_F_ACCESS_PLATFORM), кольца несут GIOVA, а не гостевые физические адреса. Прежде чем читать или писать, vhost обязан перевести каждый GIOVA в хостовый виртуальный адрес через device IOTLB. Делает это поток ядра vhost, который одалживает адресное пространство процесса QEMU через kthread_use_mm(): разрешив HVA из IOTLB, он зовёт __copy_from_user() для чтения таблицы дескрипторов и avail, и __copy_to_user() для записи used. В процессе QEMU гостевая RAM подложена большим mmap-регионом, и в норме записи в used целиком попадают внутрь этого интервала.
Напрямую VHOST_SET_VRING_ADDR гость позвать не может. Зато у него есть законный способ заставить QEMU выдать этот ioctl – VIRTIO_F_RING_RESET, механизм сброса и повторного включения отдельной виртуальной очереди. Сначала обычная передача или приём пакета заселяет карту в meta_iotlb[USED]. Затем гость пишет queue_reset, переставляет used-кольцо (queue_device) на неотображённый новый GIOVA R2 и пишет queue_enable – в ответ QEMU входит в vhost_virtqueue_restart() и выдаёт VHOST_SET_VRING_ADDR на уже существующем файловом дескрипторе, без сброса кеша метаданных. Остаётся дёрнуть очередь: кеш не инвалидирован, vq_meta_prefetch() попадает в протухшую запись, и vhost_vq_meta_fetch() линейно экстраполирует адрес по старой карте:
HVA = old_map->addr + (R2 − old_map->start) = rambase + gpa + (R2 − R)
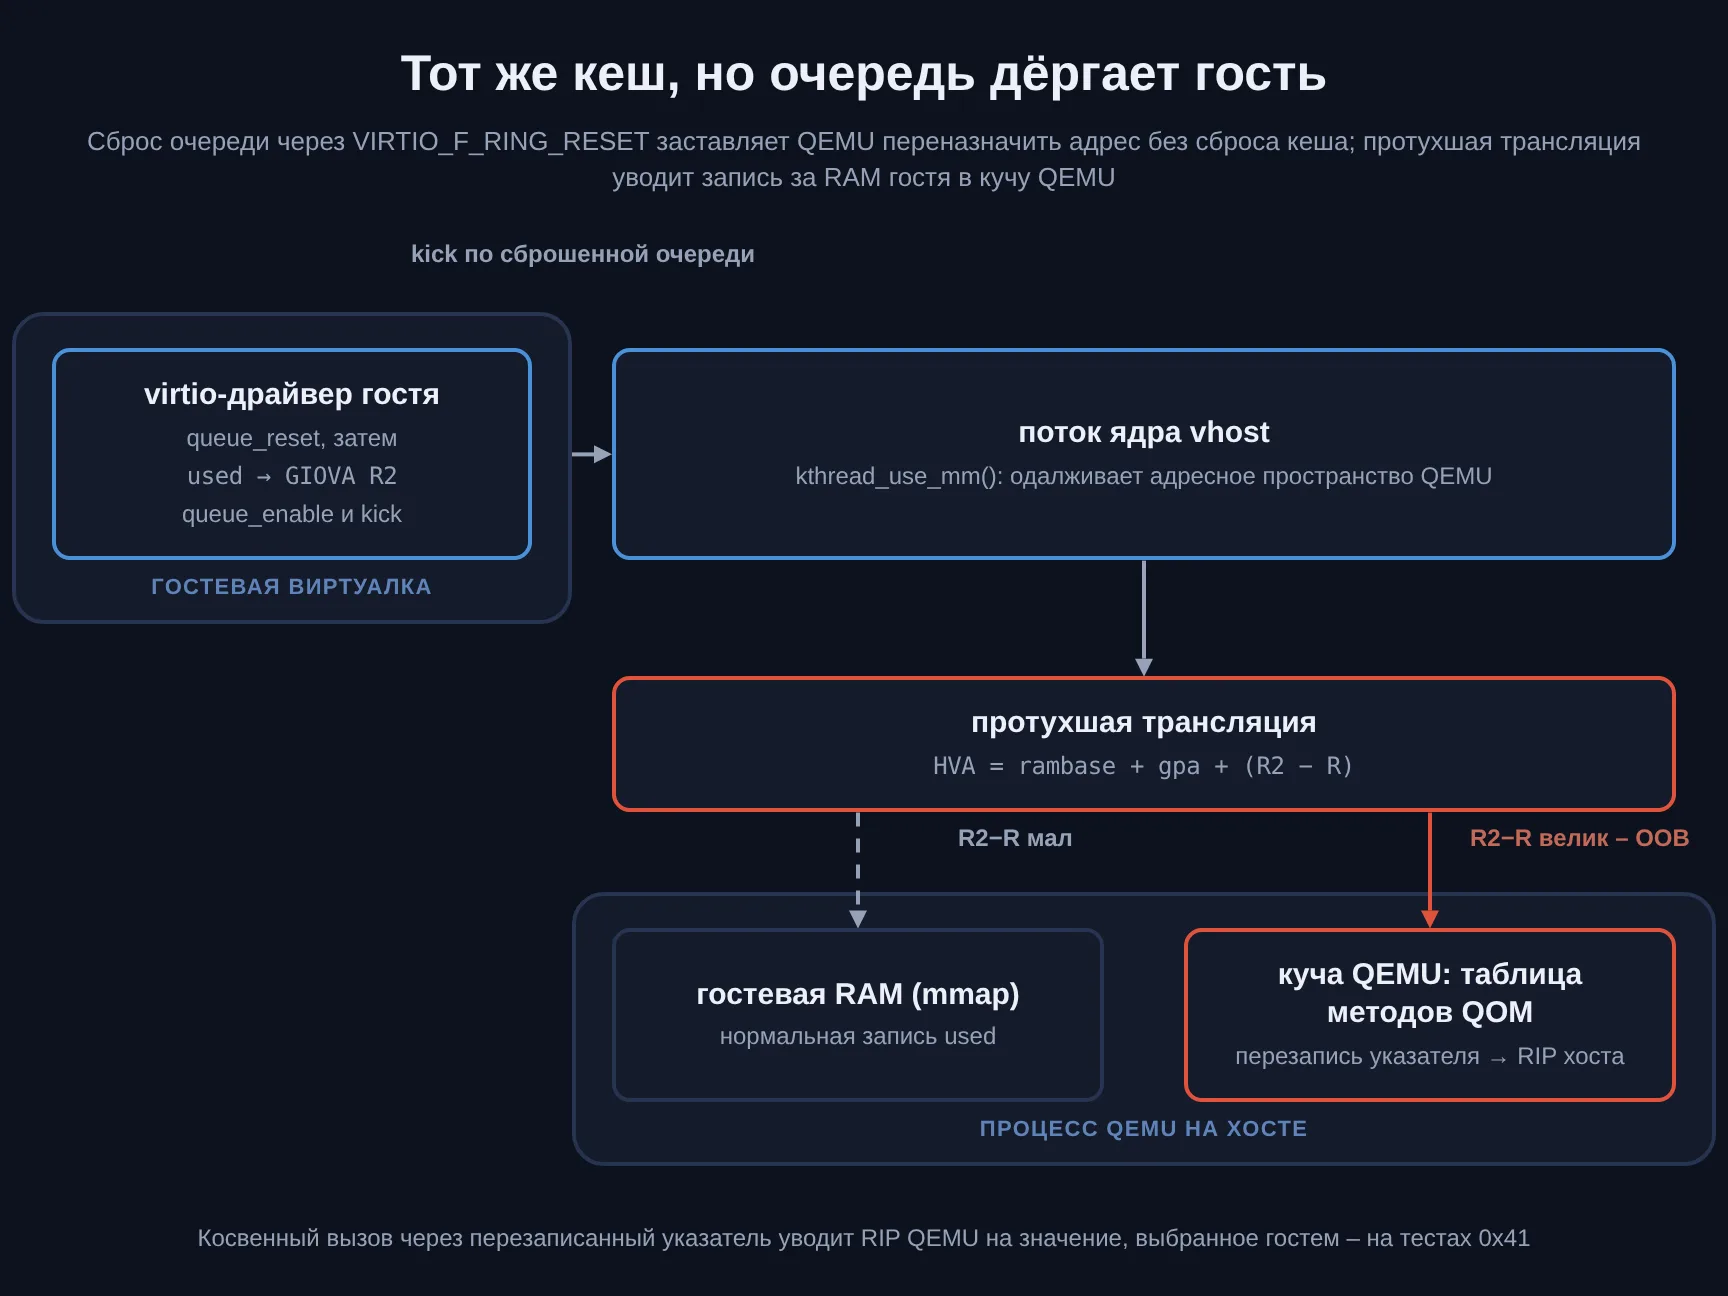
Фокус в слагаемом R2 − R. Когда разность достаточно велика, вычисленный HVA перескакивает за отображение гостевой RAM и садится в кучу процесса QEMU. Последующий __copy_to_user() пишет элементы used-кольца в память хоста, которую IOMMU гостю никогда не выдавал. Граница изоляции, ради которой virtio и ставят за vIOMMU, проламывается тем самым механизмом, который должен её держать.
RIP хоста уходит в 0x41
Запись за границу бьёт по собственной памяти процесса QEMU, а адрес назначения выбирает гость через R2. Гостевая RAM – лишь один регион адресного пространства QEMU; достаточно большой R2 − R уводит запись за него, в кучу самого QEMU. Записанные значения приходят из метаданных used-кольца, и их хватает, чтобы перезаписать восьмибайтовый указатель значением, которое выбрал гость.
Дальше в дело идёт объектная модель QEMU. QOM держит для каждого типа устройства таблицу методов – класс с указателями на функции, которые зовутся при операциях устройства. Перезаписав один такой указатель выбранным значением, гость получает то, что следующий косвенный вызов через него уведёт RIP QEMU на это значение. На тестах хостовый QEMU доходил до RIP=0x41, а цель можно построить и внутри образа самого QEMU – например, 0x555555fe0000. В этот момент обычный процесс внутри виртуалки держит в руках поток управления хостового VMM; тем же примитивом QEMU надёжно роняется в краш. Вектор требует, чтобы vhost работал в режиме device-IOTLB: virtio за vIOMMU и включённый iommu_platform. Условие не экзотическое – ровно так разворачивают virtio там, где всерьёз относятся к изоляции DMA, и именно эта конфигурация, купленная ради безопасности, открывает вектор побега.
Три строки, закрывшие десятилетнюю дыру
Фикс сбрасывает кеш метаданных в vhost_vring_set_num_addr(), проталкивая переназначенные адреса обратно через медленный путь iotlb_access_ok():
 	BUG();
 	}

+	/*
+	 * The metadata cache holds the IOTLB mapping that backed the previous
+	 * desc/avail/used addresses and vring size, both of which are being
+	 * replaced here.  iotlb_access_ok() takes a cache hit as proof that the
+	 * region was validated, so the stale entries have to go.
+	 */
+	__vhost_vq_meta_reset(vq);
+
 	mutex_unlock(&vq->mutex);
Правка живёт в одном drivers/vhost/vhost.c и совпадает по форме с тремя уже существующими местами сброса – то есть разработчики просто дописали четвёртую точку инвалидации туда, где её пропустили в 2020-м. При этом фикс намеренно оставил два меньших окна несвежести – на 2 байта и на ~256 КБ, оба в пределах собственной карты вызывающего – под будущие несекьюрити-патчи. Решение сузить security-правку до точки, закрывающей эксплуатируемость, на нашей шкале оправдано: альтернатива – вычистить всю несвежесть разом – дала бы крупнее диффа и выше риск регрессии на бэкпортах в восемь стабильных веток, а остаточные окна не выходят за mapping вызывающего и примитива не дают. Размен «минимальный безопасный бэкпорт против полной чистоты инварианта» здесь сделан в пользу бэкпорта, и для правки, которую придётся носить по ядрам от 5.10 до 7.2, это разумно.
Хронология показывает ту же склейку. Кеш meta_iotlb[] появился 28 февраля 2017 года в v4.11. Валидацию GIOVA отложили на prefetch 3 октября 2020 года в v5.9 – с этого дня баг жив. Пропущенную инвалидацию на VHOST_SET_VRING_ADDR нашли и воспроизвели произвольные чтение и запись 31 июля 2026 года; 3 августа фикс вошёл в mainline; 21 августа команда CVE ядра выдала CVE-2026-74580; 24 августа полный LPE подтвердили на всех пяти дистрибутивах; 25 августа опубликовали оценку CVSS 8.8. Первыми исправленными стабильными релизами стали 5.10.265, 5.15.216, 6.1.183, 6.6.152, 6.12.104, 6.18.45, 7.1.9 и 7.2 – проверенные Amazon Linux 6.1.180 и Azure Linux 6.6.150 до соответствующих апстрим-фиксов не дотягивают, и латает их вендорский бэкпорт поверх старой базовой версии. Amazon Linux и Oracle Linux уже выпустили адвайзори и закрыли баг в свежих релизах.
Почему этот баг опаснее честной гонки
Сложить killchain из двух идеально корректных коммитов – это другой класс задачи, чем найти переполнение. Переполнение видно в самом коде: кто-то не проверил длину. Здесь проверяли все: и автор кеша в 2017-м, и автор отложенной валидации в 2020-м – оба написали корректный код, и ни один не держал в голове чужую половину. Инвариант «кеш ручается за валидность» и инвариант «валидация случится в prefetch» по отдельности верны, а вместе образуют дыру, которую статический анализ одного коммита не ловит в принципе: ломается не строка, а композиция, разнесённая на три года и два подсистемных слоя.
Отсюда и общая оценка калибра. Проектных решений, определивших исход, в этой истории три, и ни одно не было ошибкой на своём месте: кеш ради O(1) на горячем пути, отложенная валидация ради чистого ioctl, мирозаписываемые узлы ради удобства инструментария. Каждое экономило что-то маленькое и понятное. Сумма – детерминированный root на пяти дистрибутивах, из них на четырёх для любого локального пользователя без всякой группы, и побег из виртуалки в RIP хоста, живший десятилетие. Разбор обоих векторов и кросс-дистрибутивную проверку опубликовала Tencent Zhuque Lab – но нашёл эту сумму не человек, вычитывавший drivers/vhost/ глазами, а Corvus AI, за два часа. И это, пожалуй, главная строчка: инвариант, растянутый на три года и две подсистемы, человек не удержал, а машина, которой всё равно, где проходит граница ревью и давность коммита, прошла его насквозь и предъявила root.
Автор: hacker@shifry.local